10 tecnologías que mejoran la privacidad que todo ingeniero debería conocer
[ad_1]
Como ingenieros, debemos asegurar y proteger los datos confidenciales para evitar su uso indebido y cumplir con varias leyes de protección de datos, al mismo tiempo que admitimos flujos de trabajo basados en datos como el aprendizaje automático, el análisis o el intercambio de datos. Afortunadamente, se está produciendo una innovación sorprendente en el espacio de la privacidad y la seguridad que puede ayudarnos no solo a mantener la privacidad de los datos de nuestros clientes, sino también a proporcionar una gran utilidad de los datos al mismo tiempo.
En este artículo, analizo 10 tecnologías de mejora de la privacidad (PET) diferentes que todos los ingenieros deben conocer a medida que estas PET comienzan a ser prácticas y están disponibles comercialmente.
Índice del contenido
- ¿Qué son las tecnologías de mejora de la privacidad?
- ¿Por qué son importantes las tecnologías de mejora de la privacidad?
- Ejemplos de tecnologías de mejora de la privacidad
- Cómputo multiparte seguro
- De-identification Techniques
- pseudoanonimización
- Cifrado homomórfico
- Aprendizaje federado
- Prueba de conocimiento cero
- Privacidad diferencial
- Datos sintéticos
- Entorno de ejecución de confianza
- Bóveda de privacidad de datos
- El futuro de la privacidad
- ¿Qué son las tecnologías de mejora de la privacidad?
- ¿Por qué son importantes las tecnologías de mejora de la privacidad?
- Ejemplos de tecnologías de mejora de la privacidad
- Cómputo multiparte seguro
- De-identification Techniques
- pseudoanonimización
- Cifrado homomórfico
- Aprendizaje federado
- Prueba de conocimiento cero
- Privacidad diferencial
- Datos sintéticos
- Entorno de ejecución de confianza
- Bóveda de privacidad de datos
- El futuro de la privacidad
¿Qué son las tecnologías de mejora de la privacidad?
Las tecnologías de mejora de la privacidad incluyen cualquier tecnología que aumente la privacidad y la seguridad de los datos confidenciales: información crítica como nombres de clientes, números de teléfono, direcciones de correo electrónico y números de seguro social (SSN). Ya sea que esté buscando garantizar el cumplimiento de GPDR o CCPA, o fortalecer sus sistemas contra la próxima filtración de datos, estas tecnologías son una parte indispensable del conjunto completo de herramientas de un desarrollador.
Aunque toman muchas formas, las tecnologías de mejora de la privacidad tienden a enfatizar algunos temas comunes:
- De-identification
- Ofuscación (tokenización, cifrado, pseudoanonimización)
- Aislamiento o centralización de datos sensibles
- Confianza cero/confianza distribuida (incluida la informática multipartita)
Pero antes de ver una variedad de tecnologías que mejoran la privacidad, vale la pena considerar por qué estas tecnologías son tan valiosas para los ingenieros de software.
¿Por qué son importantes las tecnologías de mejora de la privacidad?
Las tecnologías que mejoran la privacidad son importantes porque las personas tienen derecho a la privacidad de sus datos personales confidenciales. Esperan que las aplicaciones y los sitios web que usan protejan estos datos y solo los usen para los fines previstos (en lugar de adquirir un número de teléfono para 2FA y luego usarlo para publicidad ).
La creciente conciencia de este derecho se ha visto estimulada por el número cada vez mayor de violaciones de datos en los últimos años, y los reguladores han respondido creando nuevas regulaciones de privacidad de datos como CCPA (California), CPA (Colorado), GDPR (UE) y DCIA. (Canadá), por nombrar solo algunos.
Cuando considera la complejidad de proteger la información confidencial mientras se conserva la utilidad de los datos, y los dolores de cabeza y los costos de una violación de datos importante (ahora un promedio de $ 4 millones y en aumento), la importancia de las tecnologías de mejora de la privacidad se vuelve obvia.
Ejemplos de tecnologías de mejora de la privacidad
Cualquier desarrollador que trabaje con datos confidenciales debe estar familiarizado con la gama completa de tecnologías de mejora de la privacidad que puede usar para proteger estos datos. Mi objetivo al escribir esto es brindarle al menos una familiaridad transitoria con la gama completa de estas tecnologías, para que sepa qué herramientas investigar más profundamente cuando enfrente un nuevo problema de privacidad de datos.
Cómputo multiparte seguro
El cómputo multipartito seguro (MPC) es una rama de la criptografía que distribuye el cómputo entre múltiples partes donde ninguna parte individual puede ver los datos de la otra parte. La idea central es brindar a las diferentes partes una forma de calcular los datos y llegar a un resultado deseado mutuamente sin divulgar sus datos privados a otras partes.
Un caso de uso de ejemplo clásico para este protocolo es el problema del salario promedio: ¿Cómo puede un grupo de trabajadores calcular su salario promedio sin divulgar su propio salario personal a otros?
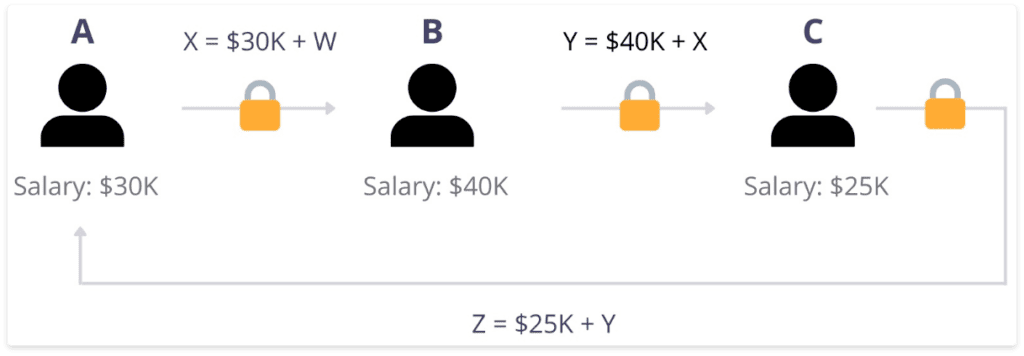
MPC puede resolver este problema usando la siguiente serie de operaciones:
- Numere a los trabajadores del primero al último en un orden arbitrario
- El primer trabajador elige un número aleatorio muy grande, suma su salario a ese número y luego envía el resultado al segundo trabajador (ver imagen a continuación)
- El segundo trabajador suma su salario al valor compartido y luego pasa ese resultado al tercer trabajador y así sucesivamente hasta que todos los trabajadores hayan aportado su salario.
- El último trabajador suma su salario y envía el resultado final al primer trabajador
- Dado que el primer trabajador eligió el número aleatorio, ahora restan ese número del número total, lo que les da la suma de todos los salarios. Luego pueden calcular el promedio dividiendo este resultado por el número total de trabajadores.
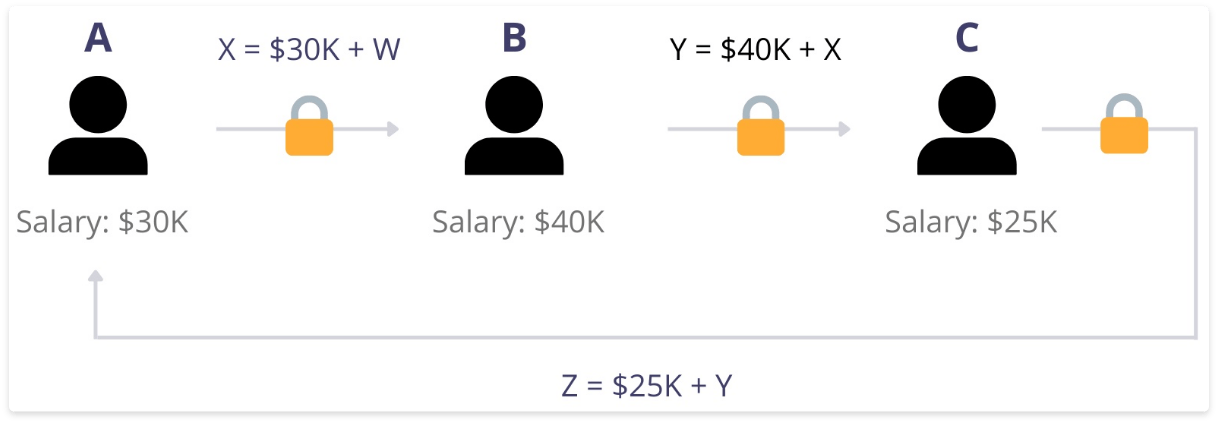
Ejemplo de MPC: el trabajador A elige un número aleatorio W y lo suma a su salario antes de pasar la suma al trabajador B, quien suma su salario a esta suma y luego se la pasa al trabajador C, y así sucesivamente. El trabajador A obtiene la suma final y puede calcular el salario promedio.
MPC se introdujo a principios de la década de 1970 y luego se formalizó por primera vez a fines de la década de 1980, pero solo recientemente pasó de ser algo estudiado en la academia a resolver problemas del mundo real para productos comerciales. MPC ahora se usa para una amplia gama de aplicaciones, que incluyen: detección de fraude, análisis de enfermedades cardíacas y agregación de funciones en conjuntos de datos privados.
Es un enfoque extremadamente poderoso de la privacidad, pero existen algunas limitaciones. El uso de MPC agrega tanto una sobrecarga computacional a un sistema existente como un alto costo de comunicación entre las diferentes partes. Esto hace que el uso de MPC no sea práctico para muchos problemas.
De-identification Techniques
La desidentificación es el proceso de eliminar información personal de un conjunto de datos. Existen múltiples métodos de desidentificación, como tokenización y k-anonimización.
Tokenización
La tokenización es un enfoque no algorítmico para la ofuscación de datos que intercambia datos confidenciales por tokens. Por ejemplo, el nombre de un cliente como "John Smith" podría reemplazarse por una cadena tokenizada como "7afd3186-369f-4898-ac93-3a4e732ebf7c". Dado que no existe una relación matemática entre "John Smith" y la cadena "7afd3186-369f-4898-ac93-3a4e732ebf7c", no hay forma de obtener los datos originales de los datos tokenizados sin acceso al proceso de tokenización.
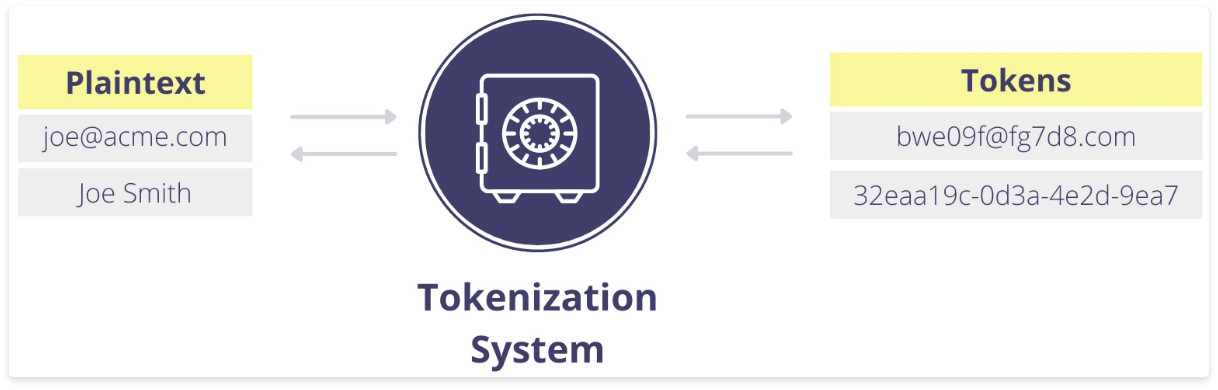
Un sistema de tokenización simple para nombres y direcciones de correo electrónico
Hay una variedad de técnicas y estilos de tokenización, incluida la tokenización de preservación de longitud, la tokenización de preservación de formato y la tokenización aleatoria versus consistente. Los diferentes enfoques tienen diferentes compensaciones y pueden ayudar a admitir diferentes casos de uso.
Puede almacenar tokens de forma segura en su base de datos o servicios posteriores porque no tienen valor explotable. Y muchos flujos de trabajo de análisis y aprendizaje automático pueden ejecutarse directamente en los datos tokenizados.
K-anonimización
La anonimización K fue propuesta por primera vez a finales de los 90 por los investigadores Latanya Sweeney y Pierangela Samarati. El K-anonimato es una propiedad de los datos. Se dice que un conjunto de datos tiene la propiedad de anonimato k si la información de cada persona en el conjunto de datos no se puede distinguir de al menos k-1 individuos.
Este es un enfoque de "seguridad en números". Esencialmente, si todos pertenecen a un grupo, cualquiera de los registros dentro del grupo podría corresponder a un solo individuo. La desventaja de la anonimización k es que no hay aleatorización, por lo que un atacante aún puede hacer inferencias sobre los datos. Además, si un atacante conoce alguna información sobre una persona, puede usar los grupos para obtener información adicional sobre esa persona. Por ejemplo, si todas las mujeres en nuestro conjunto de datos mayores de 60 años tienen cáncer de mama y los atacantes saben que Julie tiene más de 60 años y en el conjunto de datos, ahora los atacantes saben que Julie tiene cáncer de mama.
Al igual que muchos PET en esta lista, la anonimización k es una herramienta poderosa si se combina con tecnologías adicionales y se refuerza al implementar las medidas de seguridad adecuadas.
pseudoanonimización
La pseudoanonimización es una forma de ofuscación que oculta la identidad de un individuo reemplazando los valores de campo con seudónimos. Con la seudoanonimización, solo se elimina una parte de los datos de identificación, lo suficiente como para que los valores de los datos no se puedan vincular a la persona o cosa a la que se refieren (el "sujeto de datos").
Hay una variedad de métodos de seudoanonimización que incluyen la codificación, en la que los valores originales se mezclan con letras ofuscadas, y el enmascaramiento de datos, en el que se oculta una parte de los datos originales.
Con la pseudoanonimización, siempre existe el riesgo de reidentificación. Diferentes métodos conllevan diferentes riesgos, y algunos métodos no cumplen con ciertas regulaciones. Y aunque la seudoanonimización tiene muchos usos, este método por sí solo no es una solución completa de privacidad de datos.
Cifrado homomórfico
Las formas básicas de cifrado existen desde 1900 a. C. y las técnicas modernas como RSA, AES y DES se utilizan ampliamente para la transmisión y el almacenamiento seguros de datos. Sin embargo, la desventaja de todas estas técnicas es que para realizar operaciones en los datos, primero debe descifrarlos. Esto abre una posible superficie de ataque, ya que los datos descifrados se almacenan en caché en la memoria, o porque pequeños errores de codificación pueden hacer que aparezcan datos confidenciales sin cifrar en sus archivos de registro u otros lugares. Esto aumenta el alcance de sus problemas de seguridad y cumplimiento.
El cifrado homomórfico se considera ampliamente el "estándar de oro" del cifrado. Es una forma de cifrado que le permite realizar cálculos en datos cifrados sin descifrarlos primero. En la superficie, esto suena increíble. Utilidad completa de datos mientras maximiza la seguridad.
Sin embargo, en la práctica, el cifrado completamente homomórfico adolece de desafíos de rendimiento. Es demasiado lento para ofrecer un rendimiento razonable y requiere demasiada potencia informática para que lo utilicen las empresas.
Homomorphic sufre desafíos de rendimiento porque es muy complejo y necesita admitir casi cualquier operación en datos cifrados. Esta es una capacidad ideal en teoría, pero la realidad para la mayoría de los ingenieros de software es que no necesitan realizar ninguna operación arbitraria en los datos. Por lo general, necesitan realizar algunas operaciones muy específicas.
Esto es especialmente cierto cuando hablamos de datos confidenciales de clientes. No tiene sentido multiplicar o dividir dos números de teléfono, o incluso tomar una subcadena arbitraria. Los números de teléfono, las fechas de nacimiento, los números de seguridad social y muchas otras formas de datos confidenciales de los clientes tienen formatos y componentes muy específicos. Y el tipo de operaciones que desea realizar ya están predeterminados, entonces, ¿por qué sufrir un rendimiento lento para admitir operaciones innecesarias en datos cifrados?
Introduzca el cifrado polimórfico . Al igual que el cifrado homomórfico, el cifrado polimórfico admite operaciones en datos cifrados, pero está diseñado específicamente para admitir los tipos de casos de uso y operaciones que los ingenieros suelen necesitar para realizar en datos confidenciales. Por ejemplo, indexar y descifrar solo los últimos cuatro dígitos de un número de seguro social o determinar si el puntaje crediticio de un cliente está por encima o por debajo de un umbral determinado sin ver realmente el puntaje crediticio del cliente.
El cifrado polimórfico es un PET increíblemente poderoso que está listo para la empresa hoy en día.
Aprendizaje federado
El aprendizaje federado es una forma descentralizada de aprendizaje automático. En el aprendizaje automático, los datos de capacitación generalmente se agregan desde múltiples fuentes (teléfonos móviles, computadoras portátiles, dispositivos IoT, etc.) y se llevan a un servidor central para la capacitación. Sin embargo, desde el punto de vista de la privacidad, esto obviamente tiene problemas.
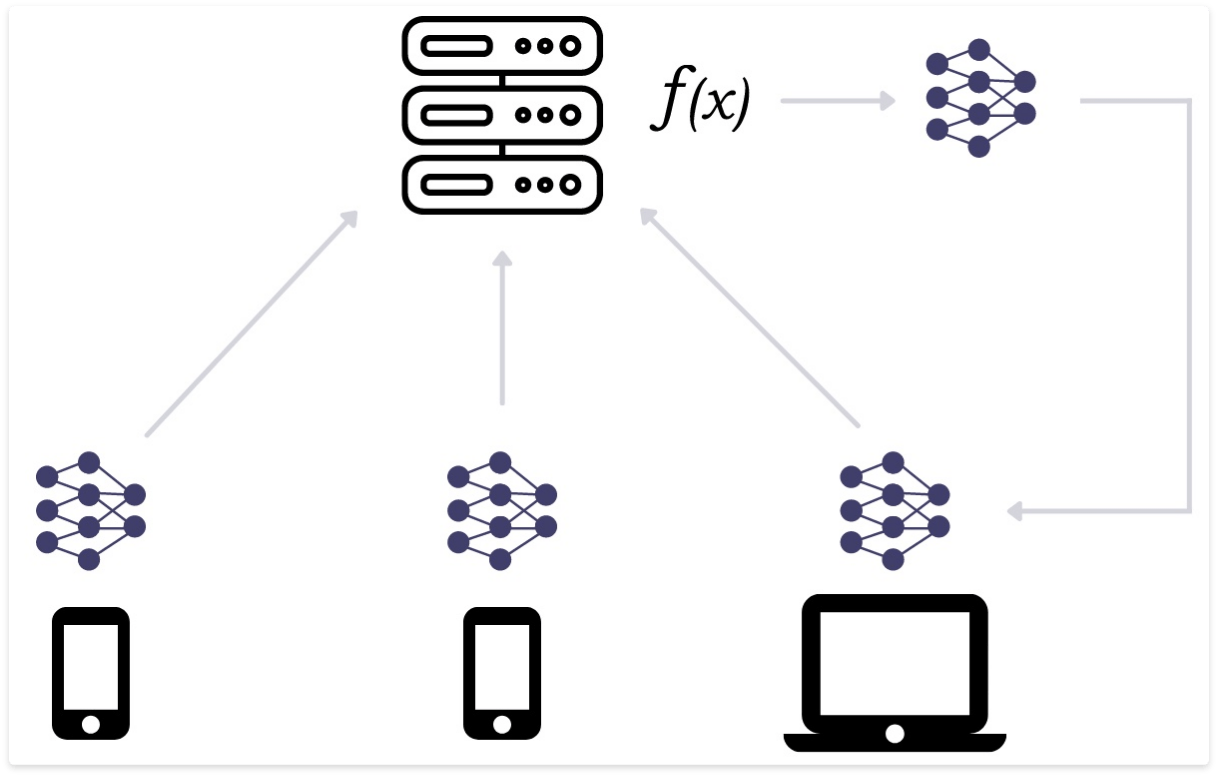
Ejemplo de aprendizaje federado. La capacitación ocurre localmente y los resultados se informan centralmente.
En un modelo de aprendizaje federado, la capacitación ocurre localmente y los resultados se informan al servidor centralizado, en lugar de las entradas sin procesar. Por ejemplo, la aplicación de aprendizaje automático centralizado está disponible directamente en todos los dispositivos. El modelo local aprende y se entrena a sí mismo en el dispositivo según la entrada del usuario y el uso del dispositivo. Luego, el dispositivo transfiere solo los resultados del entrenamiento de la copia local al servidor central.
Los resultados de todos los dispositivos descentralizados se agregan, pero sin ver ninguno de los datos del usuario. Los dispositivos de los usuarios se pueden actualizar con el modelo central recién entrenado, como se muestra en la imagen de arriba.
Puede probar esto usted mismo con el laboratorio de código de clasificación de imágenes de aprendizaje federado de Google . Sin embargo, el aprendizaje federado tiene algunas limitaciones. Requiere una comunicación frecuente entre los dispositivos y el servidor central, por lo que requiere mucho ancho de banda de red. Además, el entrenamiento local requiere suficiente poder de cómputo local y memoria para entrenar realmente el modelo. Sin embargo, empresas como Google y Amazon han invertido mucho en este PET y ha habido múltiples avances para ayudar a reducir el costo de la computación y mejorar la eficiencia de la comunicación .
Prueba de conocimiento cero
Imagínese si pudiera ir a un bar y pedir una bebida y en lugar de que el cantinero le pidiera ver su licencia de conducir para verificar su fecha de nacimiento y luego hacer los cálculos para averiguar si tiene la edad suficiente, simplemente podría preguntar: "¿Eres ¿tiene edad suficiente para comprar alcohol?”, y usted podría responder “Sí” y ellos podrían saber con seguridad si su “Sí” era cierto o no. Este tipo de escenario es posible con pruebas de conocimiento cero.
La prueba de conocimiento cero es un método que permite que una parte demuestre a otra parte que una declaración dada es verdadera sin revelar ninguna información más allá del hecho de que la declaración es verdadera.
Un ejemplo clásico de una prueba de conocimiento cero es la cueva de Ali Baba.
En este escenario hay dos personajes, Peggy (la probadora) y Víctor (el verificador). Tanto Peggy como Victor se encuentran en la entrada de la cueva, que tiene dos entradas distintas a dos caminos diferentes (A y B). Dentro de la cueva hay una puerta que conecta ambos caminos, pero solo se puede abrir con un código secreto. Peggy posee el código y Víctor quiere tenerlo, pero primero Víctor quiere asegurarse de que Peggy no esté mintiendo acerca de que posee el código.
¿Cómo puede Peggy mostrarle a Víctor que ella posee el código sin revelarlo?
Para ello, Peggy puede entrar en la cueva por cualquiera de las dos puertas (A o B). Una vez dentro, Víctor se acerca a la cueva y le grita a Peggy que regrese por uno de los dos caminos, elegidos arbitrariamente. Si Víctor grita que regrese por el camino A pero Peggy está actualmente en el camino B, solo puede regresar por A si realmente tiene el código secreto. Por supuesto, Peggy podría tener suerte si está mintiendo y ya está en el camino A, pero siempre que este proceso se repita las suficientes veces, Peggy solo puede regresar por el camino correcto si tiene el código secreto.
En términos de aplicaciones prácticas, la criptomoneda Zcash está utilizando un método criptográfico de conocimiento cero . También está siendo utilizado por clientes de ING para demostrar que sus ingresos están dentro de un rango admisible sin revelar su salario exacto.
Los desafíos con pruebas de conocimiento cero demuestran que la respuesta no está garantizada al 100% y que es computacionalmente intensiva. Se requieren muchas interacciones entre el probador y el verificador para reducir la probabilidad de tergiversación a un nivel aceptable. Esto hace que esto no sea práctico para dispositivos lentos o de baja potencia.
Privacidad diferencial
La privacidad diferencial es un PET que está experimentando un creciente interés comercial. La idea de la privacidad diferencial es que al introducir una pequeña cantidad de ruido en un conjunto de datos, el resultado de una consulta no se puede usar para inferir mucho sobre un solo individuo. La privacidad diferencial no es un proceso específico como la desidentificación, sino una propiedad que puede tener un algoritmo o proceso.
Con la privacidad diferencial, agrega una capa de privacidad al agregar ruido a los datos originales. Como consecuencia, cualquier modelado o análisis realizado con los datos resultantes tiene una precisión disminuida.
La clave para usar bien la privacidad diferencial es equilibrar cuidadosamente la necesidad de resultados precisos con la necesidad de proteger la privacidad de un individuo ofuscando esos resultados.
Datos sintéticos
Los datos sintéticos (o "datos falsos") son datos generados artificialmente que reflejan los patrones y la composición del conjunto de datos original. Es un tipo de anonimización de datos. Los datos sintéticos son una excelente solución para ciertos casos de uso, como brindarles a los ingenieros algo que tenga propiedades similares a los datos de producción con fines de prueba sin exponer la PII real del cliente. Los datos sintéticos también se utilizan ampliamente para entrenar los modelos de aprendizaje automático utilizados en los sistemas de detección de fraude.
Es un proceso complejo para generar datos de forma sintética que se ven y se sienten lo suficientemente reales como para ser útiles para pruebas u otras aplicaciones. Por ejemplo, si una empresa tiene varias bases de datos con tablas independientes que contienen el nombre de un cliente, el mismo cliente en ambas bases de datos tendría el mismo nombre. Idealmente, los datos sintéticos que se generan para este negocio pueden capturar este patrón.
Ese es un problema complejo, pero hay varias empresas con soluciones disponibles comercialmente en la actualidad.
Entorno de ejecución de confianza
Un entorno de ejecución de confianza (TEE) es un enfoque de privacidad basado en hardware. Con TEE, una CPU tiene una partición de hardware del proceso y la memoria de la computadora principal. No se puede acceder a los datos dentro del TEE desde el procesador principal y la comunicación entre el TEE y el resto de la CPU está encriptada. Las operaciones sobre los datos cifrados solo pueden tener lugar dentro del TEE.
Intel, AMD y otros fabricantes de chips ahora ofrecen chips TEE. AWS Nitro Enclaves utiliza esta tecnología para crear entornos de cómputo aislados adecuados para procesar datos altamente confidenciales como PII mientras los mantiene seguros y privados.
Bóveda de privacidad de datos
Una bóveda de privacidad de datos aísla, asegura y controla estrictamente el acceso para administrar, monitorear y usar datos confidenciales. Es tanto un patrón de diseño tecnológico como arquitectónico. Una bóveda de privacidad de datos combina múltiples PET, como cifrado, tokenización y enmascaramiento de datos junto con técnicas de seguridad de datos como confianza cero, registro y auditoría, y el principio de aislamiento.
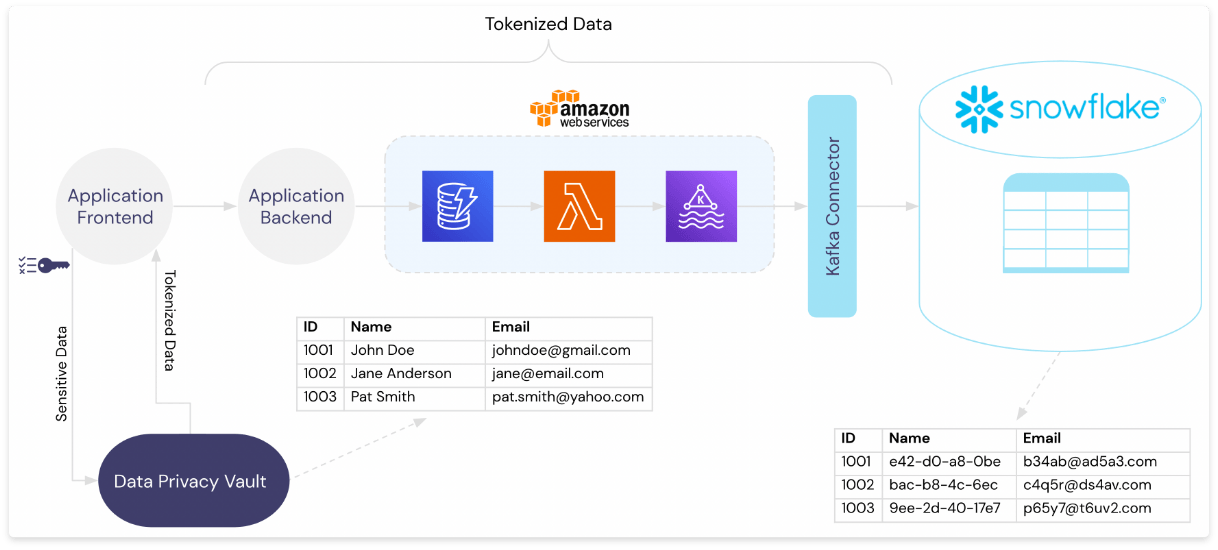
Ejemplo de uso de una bóveda de privacidad de datos. Los datos confidenciales se envían a la bóveda en el momento de la recopilación. Los datos tokenizados se almacenan aguas abajo.
Una empresa que utiliza una bóveda de privacidad de datos mueve la PII de sus clientes fuera de su infraestructura y almacenamiento de datos existentes y la coloca en la bóveda, como se muestra en la imagen de arriba. La bóveda de privacidad de datos se convierte en la única fuente de verdad para toda la PII del cliente, eliminando efectivamente el alcance de la infraestructura de aplicaciones existente de las responsabilidades de seguridad y cumplimiento de datos. Este enfoque de diseño arquitectónico para la privacidad de datos conlleva otro beneficio: reduce significativamente la complejidad de la residencia o localización de datos.
Esta tecnología fue iniciada originalmente por compañías como Apple y Netflix. A pesar de ser ampliamente considerado como el mejor enfoque de su clase para la privacidad de datos, la bóveda de privacidad de datos no ha tenido una adopción generalizada fuera de algunas de las principales empresas de tecnología. Esto se debe a la complejidad involucrada en la construcción del sistema de bóveda. Shopify tardó tres años y las contribuciones de 94 ingenieros para construir su versión de una bóveda de privacidad de datos.
El futuro de la privacidad
La privacidad de los datos no se trata solo del cumplimiento, también es lo correcto para sus usuarios. Hay una enorme cantidad de crecimiento e impulso en este espacio que va a ayudar a los ingenieros a construir sistemas mejores y más seguros, al mismo tiempo que permite a las empresas utilizar los datos que recopilan sobre los clientes para mejorar sus productos.
A medida que estas tecnologías estén disponibles comercialmente y se desarrollen capas de abstracción como API y SDK, utilizar estas tecnologías en nuestras tareas de ingeniería diarias será tan fácil y común como programar una llamada telefónica o emitir una transacción con tarjeta de crédito.
La privacidad de los datos no es tarea de los CISO ni de los oficiales de privacidad, es tarea de todos. Como ingenieros que a menudo se encargan de los aspectos técnicos de la protección de datos confidenciales, es fundamental que comprendamos el panorama de las herramientas y tecnologías que mejoran la privacidad. Y es de vital importancia que usemos este entendimiento para seguir las mejores prácticas de privacidad y honrar la confianza depositada en nosotros cuando nuestros usuarios comparten sus datos personales confidenciales.
[ad_2]
Si quieres conocer otros artículos parecidos a 10 tecnologías que mejoran la privacidad que todo ingeniero debería conocer puedes visitar la categoría Software.

Deja una respuesta