Desafíos del monitoreo híbrido y de múltiples nubes
[ad_1]
El objetivo de tener una consola central que nos permita ver lo que sucede con las operaciones de TI de nuestra organización ha sido durante mucho tiempo un objetivo para muchas organizaciones. El gol tiene mucho sentido. Sin una imagen clara de un extremo a otro, es difícil determinar dónde radican sus problemas a menos que pueda determinar si algo que sucede aguas arriba tiene efectos colaterales significativos.
Cuando tenemos estas vistas de alto nivel, naturalmente agregamos y abstraemos detalles. Por lo tanto, la capacidad de profundizar en los detalles desde una sola vista es un requisito inherente. El problema surge cuando hemos distribuido nuestras soluciones en múltiples centros de datos, regiones de la nube o incluso regiones de múltiples proveedores.
El núcleo del desafío es que nuestro monitoreo a través de registros, métricas y rastreos representa una cantidad significativa de datos, especialmente cuando no están comprimidos. Una aplicación que habla con sus registros o que no ha optimizado su configuración de registro puede generar fácilmente más contenido de registro que datos de transacciones reales. La única razón por la que no lo notamos es que los registros generalmente no se consolidan y los datos de registro se eliminan.
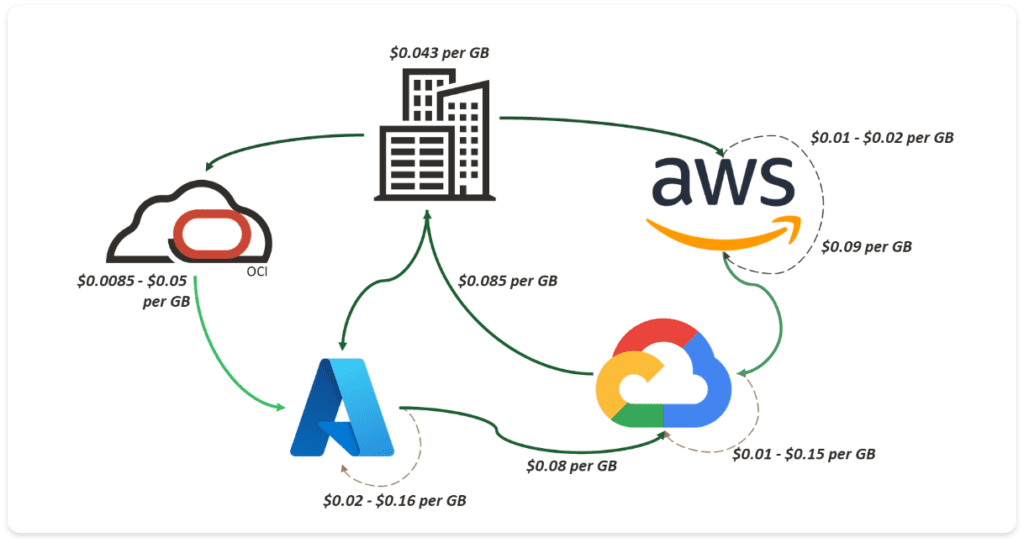
Cuando se trata de administrar el monitoreo en un arreglo distribuido y queremos consolidar nuestros registros, es posible que estemos descargando una gran cantidad de tráfico de un centro de datos o un proveedor de la nube, y eso es costoso. Los proveedores de la nube normalmente no cobran por los datos entrantes, pero según el proveedor, los datos salientes pueden ser costosos. Con algunos proveedores, incluso puede costar transferir datos entre regiones. Incluso para los centros de datos privados, existen costos en forma de ancho de banda para la conexión a la red troncal de Internet y/o el uso de líneas alquiladas. Los números también pueden variar en todo el mundo.
El gráfico a continuación contiene algunos números indicativos de mi encuesta más reciente sobre los precios publicados de los hiperescaladores líderes, y los costos locales se derivan de los precios de las líneas arrendadas.

Esto plantea la pregunta de cómo demonios puede crear un único panel de vidrio centralizado para su vigilancia sin correr el riesgo de costos de datos potencialmente significativos. ¿Dónde debo consolidar mis datos? ¿Qué significa esto si uso soluciones de monitoreo SaaS como DataDog?
Hay varias cosas que podemos hacer para mejorar la situación. Primero, echemos un vistazo a los registros y seguimientos generados. Pueden ayudar durante el desarrollo y las pruebas, pero ¿necesitamos todo eso? Si usamos marcos de registro, ¿se clasifican correctamente los registros como seguimiento, depuración, etc.? Cuando las aplicaciones utilizan marcos de registro, podemos ajustar la configuración de registro para hacer frente a la situación en la que un módulo es particularmente ruidoso. Pero para esos sistemas que son frágiles, gente que está nerviosa, una configuración o un 3aprox. La organización de apoyo al partido anula todos los acuerdos si cambia cualquier configuración. La siguiente línea de control es usar herramientas como Fluentd, Logstash o Fluentbit, que vienen con soporte completo para OpenTelemetry. Podemos introducir estas herramientas en el entorno cercano a la fuente de datos para que puedan recopilar y filtrar los registros, los seguimientos y los datos de métricas.
La forma en que funcionan estas herramientas significa que pueden consumir, transformar y enviar registros, seguimientos y métricas a su destino final en un formato compatible con la mayoría de los sistemas. Además, Fluentd y Fluentbit se pueden implementar fácilmente para desplegar y distribuir cargas de trabajo, lo que facilita la escalabilidad para clasificar los datos en general. También podemos usarlo como una función de retransmisión, lo que nos permite enrutar los datos a través de puntos específicos en una red para mayor seguridad.
Como puede ver en el diagrama a continuación, mezclamos Fluentd y Fluentbit para concentrar el flujo de datos antes de que pueda escapar. Esto nos permite reducir la cantidad de puntos en los que la red está expuesta a Internet. Una estrategia que no debe usarse como el único mecanismo para proteger la transmisión de datos, pero que ciertamente puede ser parte de un arsenal de consideraciones de seguridad. También se puede utilizar como conmutación por error en caso de problemas de conexión.
Además de filtrar y canalizar el flujo de datos, estas herramientas pueden enrutar datos a múltiples destinos. En lugar de volcar los datos que no queremos de forma centralizada, podemos consolidar los datos en un almacén de datos de serie temporal eficiente dentro del mismo centro de datos/nube y reenviar los datos identificados como valiosos. Esto entonces nos da dos opciones; En el caso de una investigación sobre un problema, podemos hacer lo siguiente:
- Identifique los datos adicionales necesarios para enriquecer el análisis central agregado e ingiera precisamente esos datos adicionales (y posiblemente refine aún más el filtrado para el futuro).
- Implemente análisis localizados e integre las vistas resultantes en nuestros paneles.
En cualquier caso, usted tiene acceso a información adicional. Yo elegiría lo primero. He visto situaciones en las que los equipos de operaciones locales eliminaron demasiado rápido los almacenes de datos locales y los datos, como los seguimientos y los registros, se comprimen bien a escala. Pero recuerde, cuando los registros contienen datos que pueden ser sensibles a la ubicación, llevarlos al centro puede plantear desafíos adicionales.

Si bien hemos mostrado en el diagrama que el centro de monitoreo está en las instalaciones, esto podría ser igualmente un producto SaaS o una de las nubes. La clave de la ubicación del centro depende de tres criterios fundamentales:
- Cualquier restricción de datos relacionada con la vista de seguridad ISO 27001 (Integridad, Confidencialidad y Disponibilidad).
- Conectividad y Costos de Conectividad. Esto dará como resultado que la ubicación de monitoreo tienda a desplazarse hacia donde se genera la mayor cantidad de datos de monitoreo.
- Supervisar la capacidad y la capacidad: factores tanto funcionales (visualizar y analizar datos) como no funcionales, tales como: B. qué tan rápido se pueden ingerir y procesar los datos de vigilancia entrantes.
Adoptar una estrategia de GitOps para garantizar que tengamos una configuración consistente y, por lo tanto, el flujo de datos del software, que bien puede implementarse en centros de datos o regiones de la nube y posiblemente incluso en múltiples proveedores de la nube, puede mantenerse consistente ya que las fuentes de monitoreo son consistentes en la configuración Cuando detectamos cambios en los filtros (para eliminarlos o incluirlos), los datos se enfocan.
Por cierto, la mayoría de los almacenes de datos de registro, ya sean archivos planos comprimidos o bases de datos, pueden procesarse no solo como un receptor de datos, sino también como una fuente de datos con herramientas como Fluentd. Por lo tanto, a través de GitOps, es posible distribuir configuraciones temporales para sus nodos de Fluentd/Fluentbit, que pueden recopilar y mover de forma masiva todos los datos nuevos requeridos para el centro desde estos almacenes de ensayo regionalizados, en lugar de acceder y atravesarlos manualmente. Pero si adopta este enfoque, le recomendamos crear plantillas para tales acciones con anticipación y usarlas como parte de un proceso operativo probado. Si se adopta una estrategia de este tipo a corto plazo como parte de un esfuerzo de solución de problemas, podría intentar recopilar demasiados datos o interrumpir las operaciones en curso sin darse cuenta. Debe hacerse con una conciencia de cómo puede afectar la vida.
Con suerte, esto ayudará a proporcionar ideas para el manejo rentable del monitoreo operativo híbrido y de múltiples nubes.
[ad_2]
Si quieres conocer otros artículos parecidos a Desafíos del monitoreo híbrido y de múltiples nubes puedes visitar la categoría Software.

Deja una respuesta